
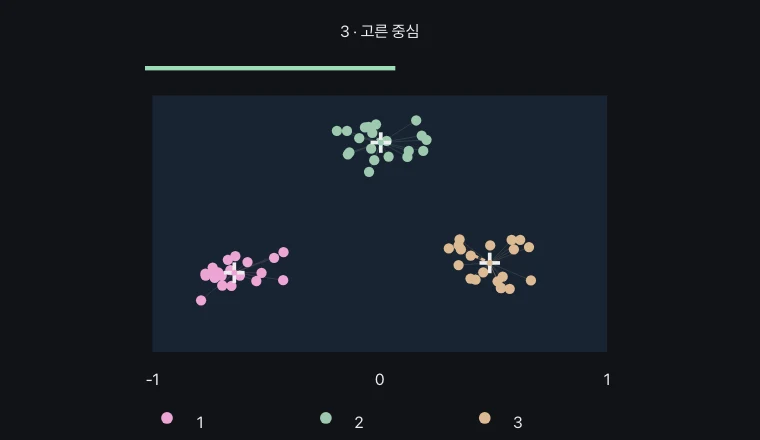
개념과 작동 원리
주어진 k개의 중심에 따라 각 점을 가장 가까운 군집에 넣습니다. 다음에는 각 군집 점들의 평균을 새 중심으로 사용합니다.
가까운 중심으로의 할당과 평균 갱신은 각각 같은 제곱거리 목적함수를 증가시키지 않는 방향입니다. 초기 중심에 따라 다른 결과에 도달할 수 있습니다.
관계식과 성립 조건
SSE는 각 점과 배정된 중심 사이 거리의 제곱합입니다. 표준 반복에서 SSE 감소가 멈췄다는 것과 가능한 모든 군집 중 전역 최적해를 찾았다는 것은 다릅니다.
유클리드 거리와 평균은 구형 군집에 유리하며 특성 스케일도 결과를 바꿉니다. k의 선택, 이상치와 빈 군집 처리 방식이 중요합니다.
가상 실험에서 읽을 변화
할당과 평균 갱신을 반복하면 오차 제곱합이 증가하지 않아요.
유클리드 거리와 고정 시드 점을 사용해요. 빈 군집은 중심을 유지해요. 지역 최솟값일 수 있고 정답 분류를 뜻하지 않아요.
핵심 관계와 기호
μⱼ = mean(xᵢ ∈ Cⱼ) · SSE = Σ‖xᵢ − μⱼ‖²
| 기호 | 뜻 | 단위 |
|---|---|---|
| k | 지정한 군집 수 | 개 |
| μⱼ | j번째 군집의 평균 중심 | 특성 좌표 |
| SSE | 군집 내 제곱거리의 합 | 특성 단위의 제곱 |
예시로 확인하기
군집 중심을 새로 정하는 기준은?
속한 점들의 평균이에요 · 할당과 평균 갱신을 반복하면 오차 제곱합이 증가하지 않아요.
자주 헷갈리는 점
- 군집 번호는 원래부터 존재하는 정답 이름이나 의미를 자동으로 보장하지 않습니다.