
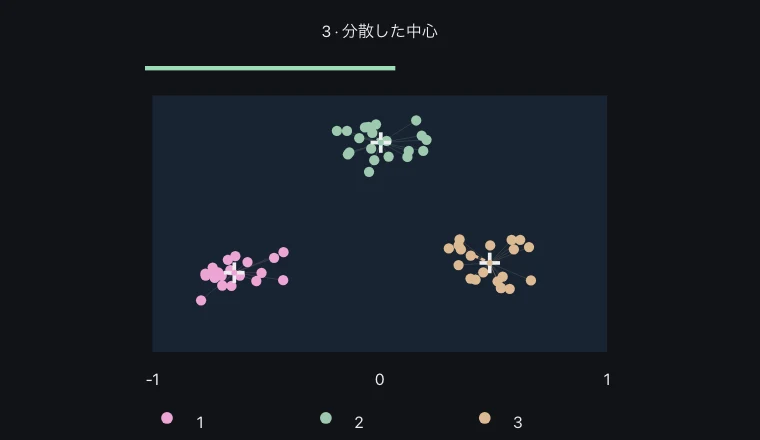
概念と仕組み
与えられた k 個の中心に対し、各点は最も近いクラスタに割り当てられる。その後、各クラスタ内の点の平均値を、新しい中心として利用する。
近隣の拠点への配分と平均の更新—これらは、同じ二乗の目的関数を増加させないように調整されている。初期の拠点によって、異なる結果が得られる可能性がある。
関係式と成立条件
SSEは、各点と割り当てられた中心との間の距離の二乗の合計です。標準的な反復において、SSEの減少を一時停止し、可能なすべてのクラスタの中からグローバルな最適解を見つけることは、異なる概念です。
ユークリッド距離と平均は、球状クラスタ分析に適しており、これは結果にも影響します。kの選択と、外れ値や疎なクラスタを扱うための方法の選択が重要です。
仮想実験で読み取る変化
割当と平均更新を繰り返すと二乗誤差和は増えません。
ユークリッド距離と固定シードを使います。空群は中心を維持します。局所最適であり正解分類とは限りません。
重要な関係式と記号
μⱼ = mean(xᵢ ∈ Cⱼ) · SSE = Σ‖xᵢ − μⱼ‖²
| 記号 | 意味 | 単位 |
|---|---|---|
| k | 指定したクラスタ数 | 個 |
| μⱼ | j番目のクラスタの平均中心 | 特徴量の座標 |
| SSE | クラスタ内の距離の二乗和 | 特徴量の単位の二乗 |
例で確かめる
各中心の更新基準は?
所属点の平均です · 割当と平均更新を繰り返すと二乗誤差和は増えません。
よくある誤解
- 軍のコード番号は、それ自体が既存の正しい名称や意味を持つことを必ずしも保証するものではありません。