
Significado y funcionamiento
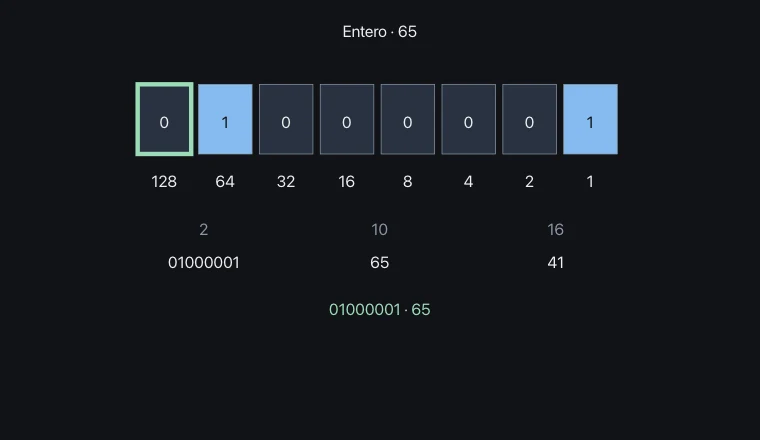
Esta es una representación de un número donde cada dígito es una potencia de 2. Con ‘n’ bits, es posible representar 2ⁿ patrones, y el rango de enteros sin signo es de 0 a 2ⁿ−1.
Unicode asigna puntos de código a los caracteres, y UTF-8 codifica esos puntos de código como secuencias de bytes. Un carácter no siempre ocupa un byte.
Relaciones y condiciones de validez
Un entero sin signo se lee como N=Σbᵢ2ⁱ. UTF-8 utiliza 1-4 bytes dependiendo del código de punto, por lo que el número de bytes de una cadena puede diferir del número de caracteres.
Las unidades que aparecen en la pantalla pueden estar compuestas por múltiples códigos. Las unidades que incluyen delimitadores y valores enteros utilizan reglas de interpretación separadas con respecto a otros codificaciones de caracteres.
Qué observar en la simulación
Los mismos bits representan información distinta según su interpretación.
Los enteros son de 8 bits sin signo; UTF-8 codifica el carácter Unicode seleccionado.
Relaciones y símbolos clave
N = Σbᵢ2ⁱ · count = 2ⁿ
| Símbolo | Significado | Unidad |
|---|---|---|
| bᵢ | Bit i-ésimo | 0 o 1 |
| byte | Grupo de 8 bits | 8 bit |
| Punto de código | Identificador de carácter Unicode | Identificador entero |
Ejemplo resuelto
¿Todo carácter UTF-8 ocupa un byte?
Depende del carácter · Los mismos bits representan información distinta según su interpretación.
Errores frecuentes
- Saber únicamente que una secuencia de bits tiene 8 bits no siempre identifica qué carácter representa.