
개념과 작동 원리
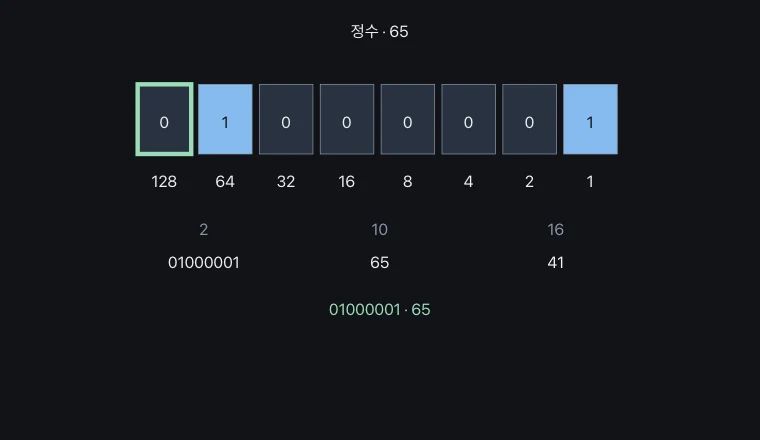
이진수는 각 자릿값이 2의 거듭제곱인 수 표현입니다. n비트로는 2ⁿ가지 패턴을 표현할 수 있고 부호 없는 정수의 범위는 0부터 2ⁿ−1입니다.
유니코드는 문자에 코드 포인트를 배정하고 UTF-8은 이를 바이트열로 표현하는 방식입니다. 문자 하나가 항상 한 바이트를 차지하는 것은 아닙니다.
관계식과 성립 조건
부호 없는 정수는 N=Σbᵢ2ⁱ로 읽습니다. UTF-8에서는 코드 포인트에 따라 1~4바이트를 사용하므로 문자열의 바이트 수는 글자 수와 다를 수 있습니다.
화면의 한 글자처럼 보이는 단위가 여러 코드 포인트로 구성될 수도 있습니다. 부호 있는 정수와 다른 문자 인코딩은 별도의 해석 규칙을 사용합니다.
가상 실험에서 읽을 변화
같은 비트열도 해석 방식에 따라 다른 정보가 돼요.
정수는 부호 없는 8비트예요. UTF-8은 선택한 유니코드 문자를 실제 바이트로 인코딩해요.
핵심 관계와 기호
N = Σbᵢ2ⁱ · count = 2ⁿ
| 기호 | 뜻 | 단위 |
|---|---|---|
| bᵢ | i번째 비트 | 0 또는 1 |
| byte | 8비트 묶음 | 8 bit |
| 코드 포인트 | 유니코드 문자 식별값 | 정수 식별자 |
예시로 확인하기
UTF-8에서 모든 문자가 한 바이트인가요?
문자마다 달라요 · 같은 비트열도 해석 방식에 따라 다른 정보가 돼요.
자주 헷갈리는 점
- 8비트라는 길이만 알고 그 비트열이 어떤 문자인지 항상 결정할 수는 없습니다.