
개념과 작동 원리
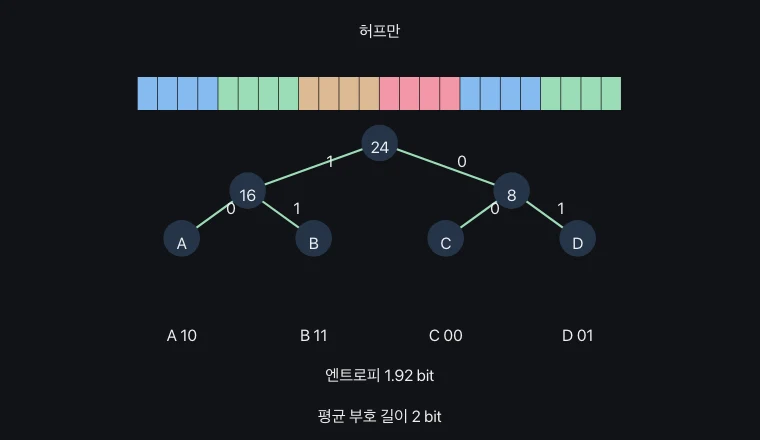
무손실 압축은 압축된 표현에서 원래 데이터를 정확히 복원할 수 있어야 합니다. 런렝스는 연속 반복을, 허프만은 기호의 발생 빈도 차이를 이용합니다.
자주 나오는 기호에 짧은 코드를 주되 코드 경계를 모호하지 않게 만들어야 합니다. 반복이 적은 자료에 런렝스를 쓰면 횟수 정보 때문에 커질 수 있습니다.
관계식과 성립 조건
기호 분포의 엔트로피 H는 이상적인 평균 정보량의 기준입니다. 여러 기호의 이진 허프만 코딩에서는 평균 길이 L을 H≤L<H+1 범위로 비교할 수 있습니다.
실험은 제한된 알파벳과 고정 원본 비트 수를 쓰고 허프만 표 저장 비용을 제외합니다. 실제 파일에서는 헤더·사전과 블록 단위 비용도 포함해야 합니다.
가상 실험에서 읽을 변화
반복과 문자 빈도가 압축 효율을 결정해요.
네 문자 알파벳의 교육용 입력이에요. 원본은 문자당 8비트, 런렝스는 문자·횟수 각 8비트예요. 허프만 표 저장 비용은 제외해요.
핵심 관계와 기호
H ≤ L < H + 1 · ratio = compressed / original
| 기호 | 뜻 | 단위 |
|---|---|---|
| H | 기호당 정보 엔트로피 | bit/기호 |
| L | 평균 코드 길이 | bit/기호 |
| 압축 비율 | 압축 크기/원본 크기 | 단위 없음 |
예시로 확인하기
허프만에서 자주 나오는 문자의 부호는?
대체로 짧아요 · 반복과 문자 빈도가 압축 효율을 결정해요.
자주 헷갈리는 점
- 코드 본문만 작아졌다는 사실이 실제 저장 파일 전체가 같은 비율로 작아졌다는 뜻은 아닙니다.