
概念と仕組み
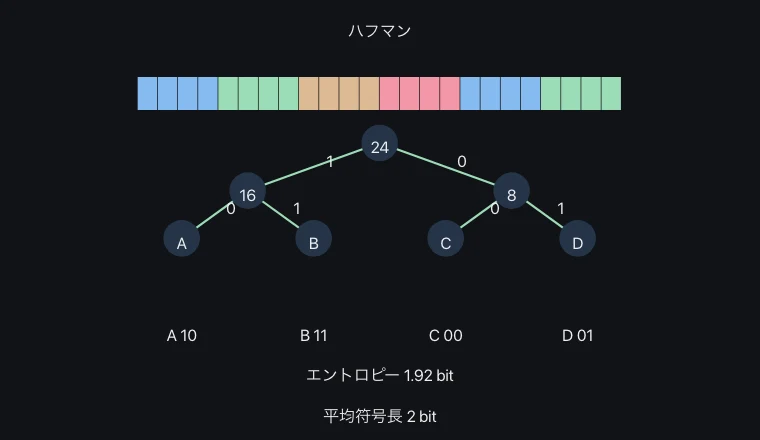
損失圧縮は、圧縮された表現から元のデータを完全に復元できる必要があります。 RunLength エンコーディングは、連続的な繰り返しを利用するのに対し、Huffman エンコーディングは、記号の頻度の差を利用します。
頻繁に出現する記号には短いコードを割り当てることは重要ですが、これらのコードは曖昧さを生じさせるべきではありません。反復が少ないデータには、繰り返し情報を利用することでデータサイズが増加する可能性があります。
関係式と成立条件
エントロピー H は、記号分布の理想的な平均情報量を参照するものです。二分ハフマン符号化において、複数の記号が存在する場合、平均符号化長 L は、H ≤ L < H+1 と比較できます。
この実験では、限られたアルファベットの使用、および固定されたオリジナルのビット数を使用せず、Huffmanテーブルのストレージコストを考慮しない。実際のファイルでは、ヘッダーと辞書のコスト、およびブロックコストも考慮する必要がある。
仮想実験で読み取る変化
反復と文字頻度が圧縮効率を決めます。
4文字の入力です。元は1文字8ビット、ランレングスは文字と回数が各8ビットです。ハフマン表の保存費用は除外します。
重要な関係式と記号
H ≤ L < H + 1 · ratio = compressed / original
| 記号 | 意味 | 単位 |
|---|---|---|
| H | 記号あたりの情報エントロピー | bit/記号 |
| L | 平均符号長 | bit/記号 |
| 圧縮率 | 圧縮後のサイズ/元のサイズ | 単位なし |
例で確かめる
ハフマンで頻出文字の符号は?
一般に短いです · 反復と文字頻度が圧縮効率を決めます。
よくある誤解
- コード自体が小さくなったとしても、実際に保存されたファイルの総体的なサイズが、同じ割合で減少したとは限りません。