
Significado y funcionamiento
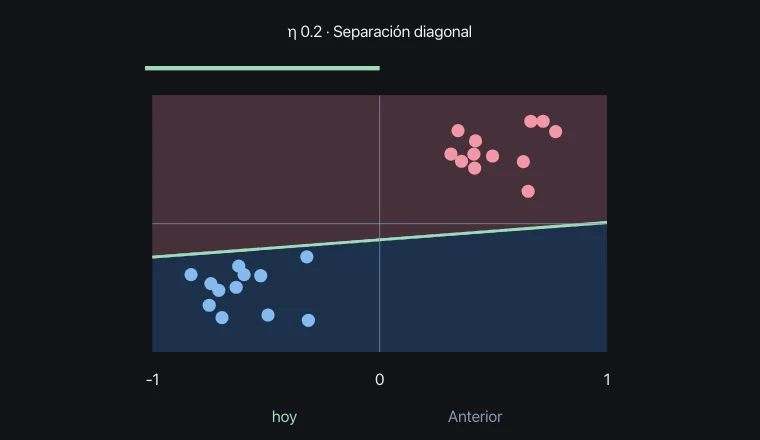
El vector de peso determina la dirección del límite de clasificación, mientras que el sesgo determina su posición. Para dos características de entrada, el límite se presenta como una línea recta.
Al ajustar los pesos y sesgos en una región no clasificada, se desplaza el límite en la dirección de la respuesta correcta. El límite o la velocidad alcanzada pueden variar dependiendo del orden de aprendizaje y los valores iniciales.
Relaciones y condiciones de validez
El experimento actualiza w a w ← w + η(y − ŷ)x, y b a *b ← b + η(y − ŷ). Si la diferencia entre el valor real y y el valor predicho ŷ es cero, la cantidad de actualización es 0.
Las propiedades de convergencia de un perceptrón estándar requieren separabilidad lineal. Por ejemplo, disposiciones como las encontradas en XOR no pueden separarse linealmente, y simplemente aumentar el número de iteraciones de entrenamiento no las resolverá con una línea recta de una sola capa.
Qué observar en la simulación
Los datos separables se aprenden con una frontera recta.
Es un clasificador binario de una capa. XOR no es separable; inicialización y orden afectan convergencia.
Relaciones y símbolos clave
w ← w + η(y − ŷ)x · b ← b + η(y − ŷ)
| Símbolo | Significado | Unidad |
|---|---|---|
| w, b | Pesos y sesgo | Parámetros del modelo |
| η | Tasa de aprendizaje | Coeficiente del modelo |
| y, ŷ | Clases reales y predichas | 0 o 1 |
Ejemplo resuelto
Con 100% de exactitud, ¿cuántos errores quedan?
Cero · Los datos separables se aprenden con una frontera recta.
Errores frecuentes
- La razón por la que las lagunas de aprendizaje no disminuyen no siempre se debe a que la tasa de aprendizaje es pequeña.