
意义与机制
当难以直接计数所有实体时,会选择一个特定区域进行调查。该区域内的实体数量除以该区域的面积,计算出密度。
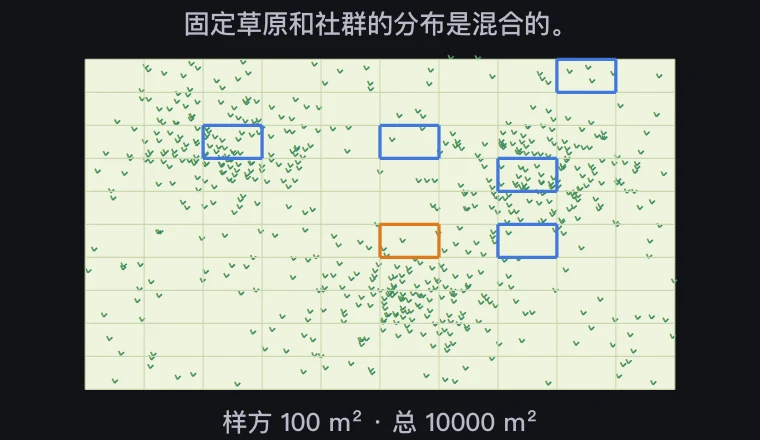
当分布集中在某个区域时,仅仅从附近位置采集样本,可能无法充分代表整体。通过随机定位或适当的分层,可以帮助减少偏差。
关系与条件
总估计的人口数量是通过将样本平均密度与总面积相乘来计算的。 在调查具有不同区域的区域时,需要考虑调查区域,而不是简单的平均计数。
随着样本量的增加,随机误差倾向于减小;然而,它无法自动消除因错误选择位置而产生的偏差。同时,它也考虑了被调查对象的实际空间分布以及移动性。
观察实验中需要注意的事物
如果重复随机抽样,较大的样本量往往会降低平均误差。即使样本数量增加,选择偏差在选择簇时仍然不会消失。
这是一个 100×100 米的虚拟草原,包含 600 个固定物体。我们混合了 240 个均匀分布的个体,以及 360 个来自三个群体的个体。为了使边缘包含的概率相等,该草原被分割成面积相等的网格,然后这些网格被恢复并提取。直接放置也符合这种网格,并且可以重复计算这些网格。我们忽略了实际植物的大小、物种分类、季节变化以及检测的遗漏。在 100 次试验中的平均绝对误差,是一个独立的随机抽样值,并不一定随着单个结果的减少而减少。
关键关系与符号
估计的人口数量 = 平均密度(个体/m²)× 10000 m²
| 符号 | 含义 | 单位 |
|---|---|---|
| 密度 | 单位面积内的个体数量 | 个体/m² |
| A_total | 总调查面积 | m² |
工作实例
总人口数量的估算方程是什么?
平均密度是样本中个体总数除以(样本数量 × 平方米数量)计算得出。然后,将结果乘以总面积 10000 m²。
常见误解
- 虽然获得了较大的样本,并不保证代表性。