
概念と仕組み
対象となる領域を特定し、その領域内の個体の数を領域の面積で割ることで、密度を算出します。
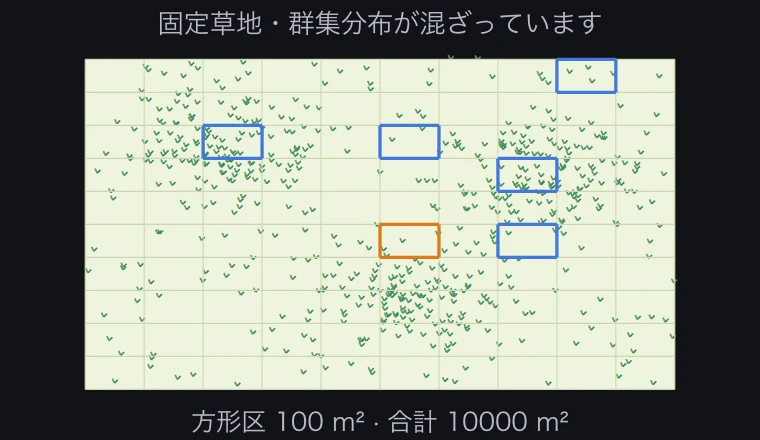
分布が特定の地域に集中している場合、近隣の場所からのみサンプルを採取するだけでは、全体を適切に代表できない可能性がある。ランダムな配置や適切な分層化を用いることで、偏りを軽減できる。
関係式と成立条件
サンプル平均密度と総面積を乗算することで、合計推定人口数を算出します。異なる地域を調査する際には、単純な平均カウントではなく、調査対象の面積を考慮する必要があります。
サンプルサイズが大きくなるにつれて、偶然の誤差は減少する傾向があります。しかし、誤って選ばれた位置によるバイアスを自動的に排除することはできません。また、調査対象の被験者の実際の空間分布と、移動性を考慮します。
仮想実験で読み取る変化
ランダムな標識を繰り返すと、多くの標本が平均誤差を減らす傾向があります。群集を選んでおく選択偏向は、サンプル数だけ増やしても消えません。
600個が固定された100×100mの仮想抄紙です。均一分布240個体と3個群集360個体を混ぜました。エッジを含める確率を同じにしようと草地を同じ面積格子で割った後、格子を復元抽出します。直接配置もこの格子に合わせて繰り返した格子を再度数えることができます。実際の植物の大きさ・種区分・季節変化・検出抜けは省略します。 100回の平均絶対誤差は別々のランダムな表記値であり、一度の結果で必ずしも減少するわけではありません。
重要な関係式と記号
推定個体数 = 平均密度 (個体/m²) × 10000 m²
| 記号 | 意味 | 単位 |
|---|---|---|
| 密度 | 単位面積あたりの個体数 | 個体/m² |
| A_全体 | 調査対象の総面積 | m² |
例で確かめる
総個体数の推定式は?
平均密度は標本の総個体数/(標本数×方形区面積)です。ここに全面積10000㎡を掛けます。
よくある誤解
- 単に大きなサンプルが得られたという事実だけで、代表性を保証するものではありません。