
意義與機制
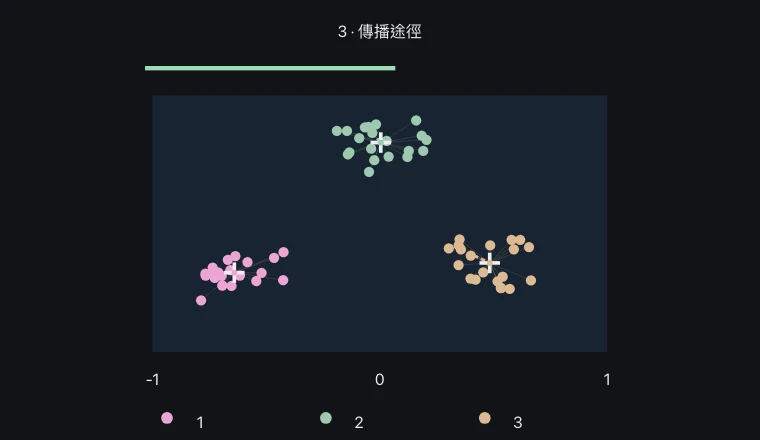
給定 k 箇中心,每個點被分配到最近的簇。隨後,每個簇內點的平均值被用作新的中心。
將分配給附近的中心,並更新平均值——這些操作方式,旨在避免使相同的平方目標函式增加。 結果可能會因初始中心而異。
關係與條件
SSE 是所有點與其分配的中心之間的距離的平方和。 在標準迭代過程中,SSE 減少過程的中途停止,以及在所有可能的簇中找到全域性最優,是兩個不同的概念。
歐幾里得距離和平均值在球狀分群分析中表現良好,並且也會影響結果。選擇 k 值,以及用於處理異常值和稀疏分群的處理方法,都非常重要。
觀察實驗中需要注意的事物
更新任務和均值,從未增加平方誤差。
使用歐幾里得距離和種子點。空簇保留其中心。區域性最小值不是真實類別。
關鍵關係與符號
μⱼ = mean(xᵢ ∈ Cⱼ) · SSE = Σ‖xᵢ − μⱼ‖²
| 符號 | 含義 | 單位 |
|---|---|---|
| k | 指定的群數 | 個 |
| μⱼ | 簇 j 的中心 | 特徵座標 |
| SSE | 簇內平方距離之和 | 平方特徵單位 |
透過範例確認
每個中心是如何更新的?
分配的平均點 · 分配和平均更新永遠不會增加平方誤差。
常見誤解
- 軍用程式碼數字本身並不能保證它們具有預先存在的、正確的名稱或意義。