
意義與機制
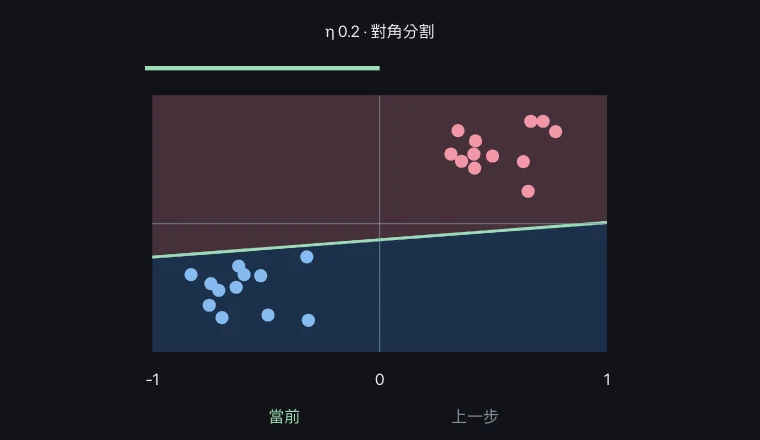
權重向量決定分類邊界的方向,而偏置則決定其位置。對於兩個輸入特徵,邊界呈現為一條直線。
透過調整未分類區域中的權重和偏置,邊界會朝著正確答案的方向移動。邊界或速度的變化,取決於學習的順序以及初始值。
關係與條件
實驗中,w 的更新為 w ← w + η(y − ŷ)x,以及 b 的更新為 b ← b + η(y − ŷ)。如果實際值 y 與預測值 ŷ 之間的差異為零,則更新量為 0。
標準的感知器收斂特性需要線性可分。例如,如XOR中出現的排列,無法透過單層直線進行線性分離。僅僅增加訓練迭代次數,也無法用單層直線解決。
觀察實驗中需要注意的事物
線性可分的資料可以用一條直線來劃分。
這是一個單層二元分類器。XOR 不可線性可分。初始化和順序會影響收斂。
關鍵關係與符號
w ← w + η(y − ŷ)x · b ← b + η(y − ŷ)
| 符號 | 含義 | 單位 |
|---|---|---|
| w, b | 權重和偏置 | 模型參數 |
| η | 學習率 | 模型係數 |
| y, ŷ | 實際類別與預測類別 | 0 或 1 |
透過範例確認
在 100% 的精度下,還剩下多少錯誤?
零· 線性可分的資料可以用一條直線來學習。
常見誤解
- 學習上的差距不會減少,這並非總是因為學習速度較慢。