
意义与机制
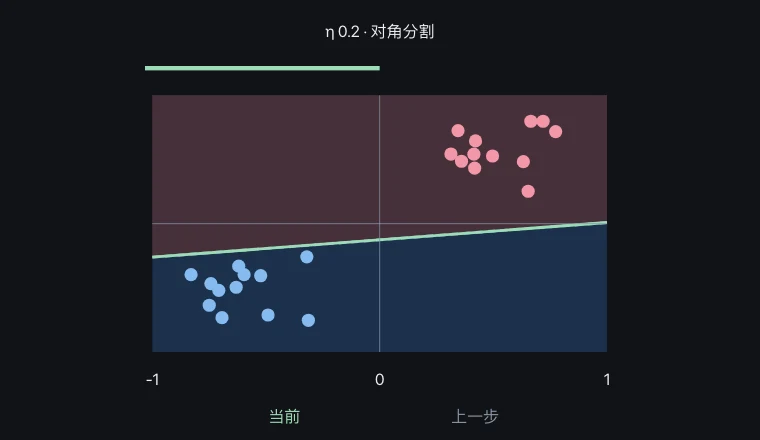
权重向量决定分类边界的方向,而偏置则决定其位置。对于两个输入特征,边界呈现为一条直线。
通过调整未分类区域中的权重和偏置,边界会朝着正确答案的方向移动。边界或速度的变化,取决于学习的顺序以及初始值。
关系与条件
实验中,w 的更新为 w ← w + η(y − ŷ)x,以及 b 的更新为 b ← b + η(y − ŷ)。如果实际值 y 与预测值 ŷ 之间的差异为零,则更新量为 0。
标准的感知机收敛特性需要线性可分。例如,如XOR中出现的排列,无法通过单层直线进行线性分离。仅仅增加训练迭代次数,也无法用单层直线解决。
观察实验中需要注意的事物
线性可分的数据可以用一条直线来划分。
这是一个单层二元分类器。XOR 不可线性可分。初始化和顺序会影响收敛。
关键关系与符号
w ← w + η(y − ŷ)x · b ← b + η(y − ŷ)
| 符号 | 含义 | 单位 |
|---|---|---|
| w, b | 权重和偏置 | 模型参数 |
| η | 学习率 | 模型系数 |
| y, ŷ | 实际类别与预测类别 | 0 或 1 |
工作实例
在 100% 的精度下,还剩下多少错误?
零· 线性可分的数据可以用一条直线来学习。
常见误解
- 学习上的差距不会减少,这并非总是因为学习速度较慢。